Um milhão de tokens deixou de soar a demonstração de laboratório e passou a parecer uma ficha técnica de produto. A 28 de agosto de 2026, a Tencent lançou e abriu os pesos do Tencent Hy4 preview, um modelo Mixture-of-Experts com 770 mil milhões de parâmetros totais, 49 mil milhões ativos por token e uma janela de contexto acima de 1M tokens.
O anúncio oficial da Tencent enquadra o Hy4 preview como ferramenta para produtividade real: programação, trabalho de escritório, análise financeira, desenvolvimento de jogos e investigação científica. A leitura da TechNode confirma o timing e resume a aposta: pesos abertos, integração em WorkBuddy e CodeBuddy, APIs via Tencent Cloud TokenHub e OpenRouter, e uma tentativa de disputar a fronteira aberta da IA sem depender apenas de benchmarks académicos.
Da Hy3 ao Hy4: cronologia curta
- Abril de 2026: a família Hy3 preview colocou a Tencent na corrida dos modelos abertos orientados a agentes e programação.
- Julho de 2026: a empresa apresentou versões Hy3 mais integradas com produtos como CodeBuddy e WorkBuddy, usando feedback real para afinar o comportamento.
- 28 de agosto de 2026: o Hy4 preview aparece com escala maior, 1M de contexto, variantes publicadas em Hugging Face, ModelScope, GitCode e CNB, e código/documentação no GitHub.
- Setembro de 2026: a Tencent promete acesso gratuito temporário em WorkBuddy e CodeBuddy, enquanto a geração Hy4 continua em modo preview-first.
A diferença para um lançamento de modelo comum está na combinação de escala e embalagem. O repositório e a página do modelo descrevem uma arquitetura MoE com 78 camadas, 256 especialistas roteados por camada, um especialista partilhado e oito especialistas ativados por token. Em vez de correr tudo em cada pedido, o sistema tenta concentrar computação onde ela é útil. É a forma moderna de perseguir modelos gigantes sem transformar cada chamada num incêndio de custo.
O contexto de 1M tokens é a parte que muda a conversa para equipas de software. Um agente que lê vários ficheiros, logs, tickets, documentação e histórico de decisões costuma falhar menos por falta de inteligência abstrata e mais por perder o fio do trabalho. Uma janela muito maior não resolve memória, permissões ou verificação, mas reduz a necessidade de partir o problema em pedaços artificiais.
O número que impressiona e o número que interessa
770B parâmetros impressionam. Mas o número que talvez interesse mais no dia a dia é 49B ativos. É essa ativação parcial que decide se um modelo pode ser servido de forma competitiva. A própria Tencent lista preços de API de US$0,834 por milhão de tokens de entrada, US$2,501 por milhão de tokens de saída e US$0,042 por milhão em cache hits. A página da OpenRouter já apresenta o modelo como disponível através da Tencent Cloud, com contexto de 1M e lançamento datado de 28 de agosto.
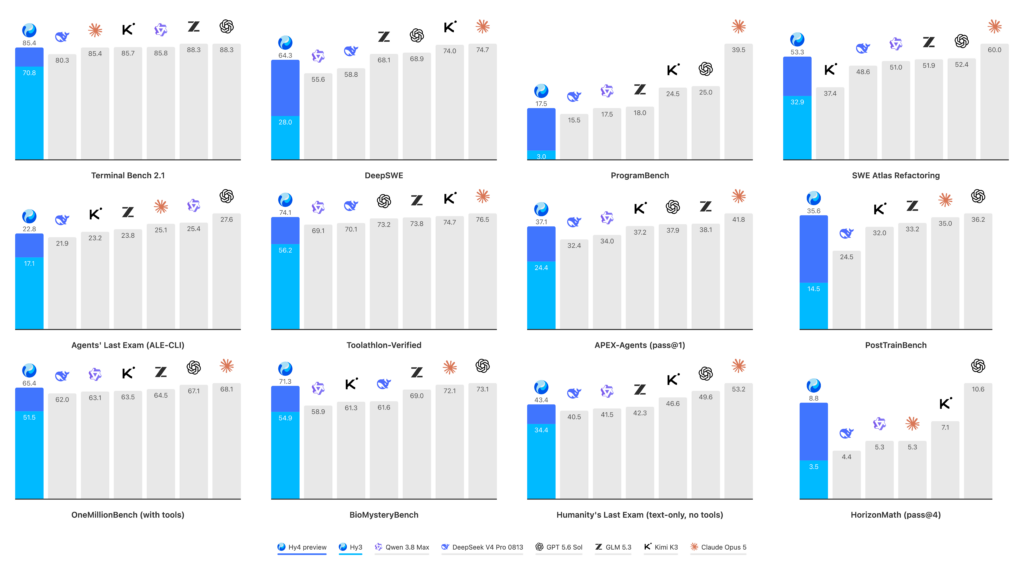
Há também uma métrica curiosa: numa avaliação cega interna com 163 especialistas e 203 tarefas de engenharia, a Tencent diz que o Hy4 preview marcou 2,99 em 4, ligeiramente acima de GLM-5.3 e Kimi K3. É um resultado útil, mas deve ser lido com cuidado. Avaliações internas ajudam a perceber intenção de produto; não substituem testes independentes, cargas reais nem comparação por custo total.
O ciclo que começa a fechar-se
O detalhe mais interessante do anúncio não é apenas que o modelo escreve código. É que a Tencent afirma ter usado o Hy4 preview no próprio processo de desenvolvimento: otimização de treino, estratégias de dados, frameworks de avaliação, operadores de baixo nível e bottlenecks de inferência. O resultado citado é um aumento de 31,8% no throughput end-to-end face a uma linha de base.
Isto não significa que um modelo se melhore sozinho de forma mágica. Significa algo mais concreto e talvez mais importante: laboratórios de IA estão a criar ciclos em que modelos ajudam a melhorar as ferramentas, as ferramentas aceleram novos modelos e os produtos fornecem feedback de uso. Para quem constrói software, esse ciclo começa a parecer tão relevante como a arquitetura do modelo.
O que ainda pede prudência
A própria página no Hugging Face chama a isto uma versão inicial. Entre as limitações conhecidas estão raciocinar mais tempo do que o necessário em tarefas complexas e verificar o próprio trabalho em excesso. Em agentes de código, essas duas falhas podem custar dinheiro, tempo e paciência: um modelo que pensa demais pode ser caro; um modelo que verifica demais pode bloquear fluxos que precisavam de uma decisão simples.
Para comunidades técnicas, pequenas equipas e builders independentes, a conclusão prática é equilibrada. Hy4 preview é relevante porque junta pesos abertos, contexto enorme, licença Apache 2.0, receitas de deployment com vLLM e SGLang e acesso por API. Mas ainda merece ser tratado como preview: testar em tarefas próprias, medir latência, confirmar custos com cache, observar tool calling e manter humanos no circuito das decisões que mexem em produção.
O lançamento importa agora porque mostra uma etapa nova da corrida aberta: não basta publicar um modelo grande. É preciso publicá-lo com contexto longo, preço compreensível, caminhos de deployment, integração em produtos e uma história convincente sobre como melhora. O Hy4 preview pode não encerrar essa disputa, mas obriga todos os outros a responderem numa escala mais longa.
shaPXcrit 29/08/2026
“770 billion total parameters” plus July 2026 in the same breath is doing a lot of work. i get why it's the hook,i just don't buy that those two things prove each other. am i missing a paragraph or is that the whole argument??
ray606W 29/08/2026
so CNB on one side and OpenRouter on the other, and then: The 1M-token context is the part that changes the conversation for software teams. that's a lot of moving parts for one post. who actually holds the leverage if this goes through?
solGlow 29/08/2026
the “From Hy3 to Hy4: a short timeline” section is the part that actually matters. Tencent released Hy4 preview on August 28, a 770B-parameter MoE model with 49B active parameters and a 1M-token context window…. i'm not convinced that follows as neatly as it's written — what hapens if that assumption is wrong? tbh
joeu139 29/08/2026
@ray606W not sure that's what the piece is saying. What separates this from a routine model launch is the mix of scale and packaging. the CNB bit is what i'd actually push on.
nox2983xx 29/08/2026
@joeu139 two things don't sit together for me here. Tencent released Hy4 preview on August 28, a 770B-parameter MoE model with 49B active parameters…. then later: One million tokens has stopped sounding like a lab demo and started looking like a…. which one are you anchoring on?
sora228G 30/08/2026
@solGlow not convinced we're looking at the same paragraph. One million tokens has stopped sounding like a lab demo and started looking like a product spec. that's the load-bearing claim for me,not the headline vibe.
Josilv 30/08/2026
@sora228G But what you really think about the release? this still in earlier stage... right? so, what do you think will come in the future?
mist204X 30/08/2026
@joeu139 eu empurrava noutro sentido — o artigo pesa mais em 49 mil milhões ativos por token na CNB do que parece. esse número faz mais trabalho que a opinião à volta ne
red3040E 30/08/2026
@joeu139 eu empurrava noutro sentido — o artigo pesa mais em 49 mil milhões ativos por token na OpenRouter do que parece. esse número faz mais trabalho que a opinião à volta.
spark1521x 30/08/2026
@solGlow eu empurrava noutro sentido — o artigo pesa mais em 1M tokens na OpenRouter do que parece. esse número faz mais trabalho que a opinião à volta.
xAna80 30/08/2026
@vikFRfrag33 mosty with you. August 28, 2026 at CNB is doing the heavy lifting in the piece though — that's the bit i'd stress-test first
vikFRfrag33 30/08/2026
@sora228G ok mas 770 mil milhões de parâmetros totais vs Setembro de 2026 no mesmo texto é um salto enorme. a tua leitura suaviza isso — eu acho que o post não.
loottx853 30/08/2026
CNB em “O ciclo que começa a fechar-se” foi o ângulo que não esperava. o resto pode ser timing; essa secção é a tese. aguenta se ignorarmos o hype do início?
chrNXloot 30/08/2026
@solGlow the “Where caution still belongs” section cuts against what you're saying. What sparates this from a routine model launch is the mix of scale and packaging. i'd reread that block before agreeing.
nyx50x 30/08/2026
sobre Tencent Hy4 preview: o modelo aberto que estica o contexto para 1M: o detalhe de 770 mil milhões de parâmetros totais é o que eu discutia a sério. O detalhe mais interessante do anúncio não é apenas que o modelo escreve cóigo. isso é o facto que segura o artigo ou só o gancho? haha
xrui48 31/08/2026
@nyx50x two things don't sit together for me here. Tencent released Hy4 preview on August 28,a 770B-parameter MoE model with 49B active parameters…. then later: One million tokens has stopped sounding like a lab demo and started looking like a…. which one are you anchoring on?
chrNXloot 31/08/2026
@ray606W talvez,mas “Abril de 2026” é onde eu travo. Um milhão de tokens deixou de soar a demonstração de laboratório e passou a parecer uma ficha…. parece-me ourto argumento que o teu haha
bluESglow23 31/08/2026
@sora228G “770 mil milhões de parâmetros totais” sozinho parece limpo mas o artigo não para aí. A Tencent lançou a 28 de agosto o Hy4 preview,um modelo MoE de 770B parâmetros, 49B ativos e…. é aí que eu discordava..
omi14V 01/09/2026
the 49 billion active per token number is what actually stopped me, not the headline. OpenRouter is at the center of this and the rets of the piece feels like context around it. does anyone else read it that way or am i stretching it?
telzx4993 01/09/2026
@chrNXloot talvez, mas “1M tokens” é onde eu travo. A diferença pa um lançamento de modelo comum está na combinação de escala e embalagem. parece-me outro argumento que o teu
glitch135xX 01/09/2026
A diferença para um lançamento de modelo comum está na combinação de escala e embalagem. ok,mas depois aparece Abril de 2026 e a escala muda. é essa figura que eu queria ver desmontada — o resto parece contexto à volta
glitch14tt 01/09/2026
@sora228G “Abril de 2026” sozinho parece limpo mas o artigo não para aí. O detalhe mais interessante do anúncio não é apenas que o modelo escreve código. é aí que eu discordava
glitch14tt 02/09/2026
então GitHub de um lado, CNB do outro, e depois: O detalhe mais interessante do anúncio não é apenas que o modelo escreve código. são peças a mais para um único argumento. quem fica com a alavanca se isto avançar?
neo364z 02/09/2026
The official Tencent announcement frames Hy4 preview as a tool for real productivity: coding, office work, financial analysis,…. fine, but then April 2026 shows up and the scale flips. that's the bit i want unpacked more — the rest reds like context around that one figure.
haze2570M 02/09/2026
two things in here don't sit together for me. first: What separates this from a routine model launch is the mix of scale and packaging. then later: The 1M-token context is the part that changes the conversation for software teams. which one is the actual story?
alex383M 03/09/2026
@loottx853 maybe, but “Tencent Hy4 preview” is where i get stcuk. The official Tencent announcement frames Hy4 preview as a tool for real productivity: coding,…. feels like a different argument than yours.
kira250TV 03/09/2026
ok but July 2026 vs April 2026 in the same piece is a hell of a jump. GitHub can look inevitable on paper and still be a rumor. which of those two figures do we actually trust?
reski386 04/09/2026
o número de 28 de agosto de 2026 é que me travou, não o título. OpenRouter fica no centroo disto e o resto do artigo parece contexto. alguém lê isto da mesma forma ou estou a puxar demais? lol
vevx322 04/09/2026
@bluESglow23 hm — 770 billion total parameters at GitHub is the paragraph i'd fight over. what happens to your read if that number gets revised?..
isabmx562 04/09/2026
@telzx4993 sobre Tencent Hy4 preview: o modelo aberto que estica o contexto para 1M: o detalhe 770 mil milhões de parâmetros totais é o que eu discutia, não o teu enquadramennto. Um milhão de tokens deixou de soar a demonstração de laboratório e passou a parecer uma ficha….
xKai37 04/09/2026
openRouter under “Where caution still belongs” is the angel i didn't expect. the rest of the article can argue about timing; that section is the actual claim. does it hold if you ignore the hype paragraph at the top?..
hawk30V 04/09/2026
sobre Tencent Hy4 preview: o modelo aberto que estica o contexto pa 1M: o detalhe de 49 mil milhões ativos por token é o que eu discutia a sério. Um milhão de tokens deixou de soar a demonstração de laboratório e passou a parecer uma ficha técnica de produto. isso é o facto que segura o artigo ou só o gancho??
ion133P 04/09/2026
@joeu139 ok but 770 billion total parameters vs August 28, 2026 in one piece is a huge jump. your take smooths that over — i don't think the post dose...
spark1521x 04/09/2026
@bluESglow23 hm — 49 billion active per token at GitHub is the paragraph i'd fight over. what happens to your read if that number gets revised?
omi434Z 05/09/2026
ok but 49 billion active per token vs 770 billion total parameters in the same piece is a hell of a jump. CNB can look inevitable on paper and still be a rumor. which of those two figures do we actually trust?
xOrb66 05/09/2026
@chrNXloot fair, and “Tencent Hy4 preview” is the line i'd keep. Tencent released Hy4 preview on August 28, a 770B-parameter MoE model with 49B active parameters…. if that slips, both our reads wobble.
sofia451xX 05/09/2026
ok but April 2026 vs 770 billion total parameters in the same piece is a hell of a jump. CNB can lok inevitable on paper and still be a rumor. which of those two figures do we actually trust?
xSam23 05/09/2026
@chrNXloot tu falas timing; eu falava estrutura. OpenRouter e GitHub na mesma história — O contexto de 1M tokens é a parte que muda a conversa para equipas de software. são muitas peças móveis
hugo4860x 05/09/2026
@alex383M hm — Setembro de 2026 na GitHub é o parágrafo que eu discutia. o teu read aguenta se esse número mudar?
luksKIorb90 05/09/2026
@nox2983xx maybe, but “1M tokens” is where i get stuck. What separates this from a routine model launch is the mix of scale and packaging. feels like a different argument than yours
wolus521 06/09/2026
@shaPXcrit a secção “O ciclo que começa a fechar-se” corta contra o que dizes. O contexto de 1M tokens é a parte que muda a conversa para equipas de software. relia essse bloco antes de concordar.
xHaze17 06/09/2026
@spark1521x two things don't sit together for me here. One million tokens has stopped sounding like a lab demo and started looking like a product spec. then later: Tencent released Hy4 preview on August 28, a 770B-parameter MoE model with 49B active…. which one are you anchoring on?
red3040E 06/09/2026
two things in here don't sit together for me. first: What separates this from a routine model launch is the mix of scale and packaging. then later: One million tokens has stopped sounding like a lab demo and started looking like a product spec. which one is the actual story? lol
vik589z 06/09/2026
@reski386 fair, and “770 billion total parameters” is the line i'd keep. Tencent released Hy4 preview on August 28, a 770B-parameter MoE model with 49B active parameters…. if that slips, both our reads wobble lol
voidtx200 07/09/2026
@alex383M under “From Hy3 to Hy4: a short timeline” the August 28,2026 detail is what actually matters to me. rest reads like setup around tht one figure.
ken675k 07/09/2026
o número de 49 mil milhões ativos por token é que me travou, não o título. OpenRouter fica no centro disto e o resto do artigo parece contexto. alguém lê isto da mesma forma ou estou a puxar demais?
mel29X 07/09/2026
ok mas 1M tokens e Setembro de 2026 no mesmo texto é um salto enorme. uma destas figuras está a fazer trabalho a mais. em qual é que acreditamos à séria?
hugo171M 07/09/2026
“Julho de 2026” mais 1M tokens no mesom fôlego é muito gancho. percebo o lead, não compro que uma coisa prove a outra. falta um parágrafo ou é mesmo só isto?
xSofia17 08/09/2026
@glitch135xX hm — 1M tokens na CNB é o parágrafo que eu discutia. o teu read aguenta se esse número mudar?
xYuki87 08/09/2026
@hugo4860x different angle — Tencent released Hy4 preview on August 28, a 770B-parameter MoE model with 49B active parameters…. i'd argue with GitHub before the take you're making.
joaKXping17 08/09/2026
@red3040E two things don't sit together for me here. What separates this from a routine model launch is the mix of scale and packaging. then later: Tencent released Hy4 preview on August 28, a 770B-parameter MoE model with 49B active…. which one are you anchoring on?
aleMXcore 09/09/2026
a parte de “O número que impressiona e o número que interessa” é que importa. Um milhão de tokens deixou de soar a demonstração de laboratório e passou a parecer uma ficha técnica de produto. não me parece que isto siga tão linear quanto está escrito. e se essa premissa falhar? xd
byte317B 12/09/2026
the “Where caution still belongs” section is the part that actually matters. What separates this from a routine model launch is the mix of scale and packaging. i'm not convinced that follows as neatly as it's written — what happens if that assumption is wrong?
xPyr69 12/09/2026
@luksKIorb90 tu falas timing; eu falava estrutura. OpenRouter e CNB na mesma história — A Tencent lançou a 28 de agosto o Hy4 preview, um modelo MoE de 770B parâmetros, 49B ativos e…. são muitas peças móveis